Klaster GlusterFS jako podstawa chmury prywatnej
Wdrożenie GlusterFS pod 40 TB+ redundantnego klastra storage na czterech węzłach: typy woluminów, wady, zalety i porównanie z Ceph oraz BeeGFS.
Opublikowano 4 min czytania
- GlusterFS
- Ceph
- storage
- klaster
- chmura prywatna
Stale rosnąca ilość przechowywanych danych wymusza szukanie innych metod ich składowania niż pojedyncza macierz. Rozproszony system plików to w uproszczeniu system działający na kilku serwerach komunikujących się przez sieć. Jest on podstawą zarówno chmur komercyjnych dostawców, jak i chmur prywatnych.
Nieistotne, czy wybierzemy GlusterFS, XtreemFS czy Ceph. Każdy ma swoje wady i zalety, a oprogramowanie trzeba dopasować do potrzeb, nie odwrotnie.
Co powstało
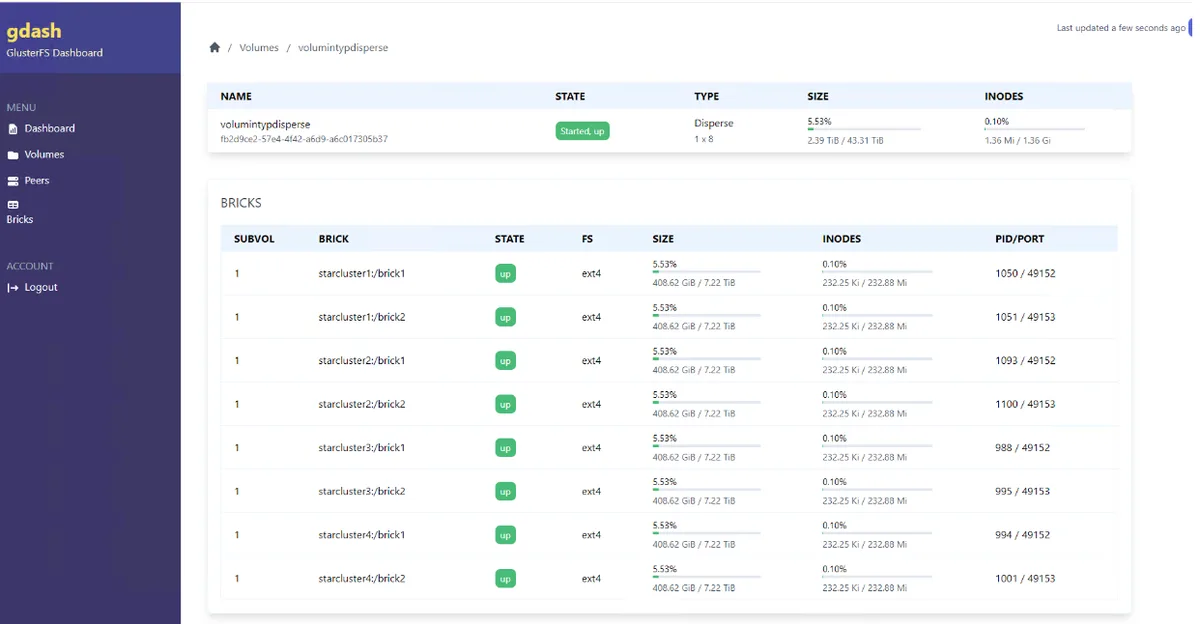
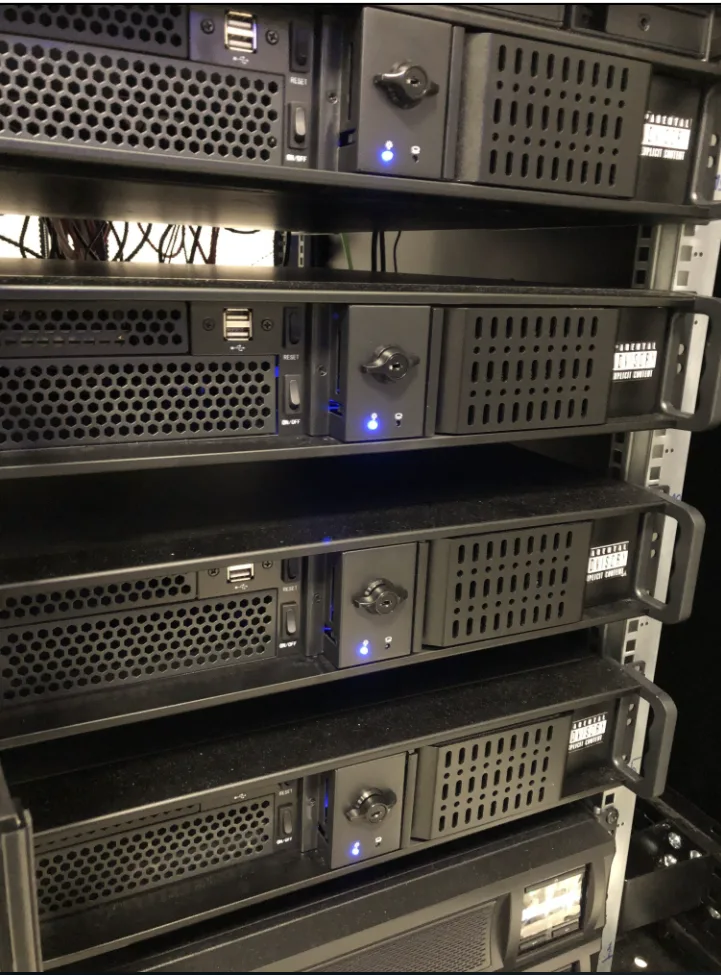
Implementacja klastra GlusterFS na czterech węzłach zakończyła się powodzeniem. Rozważano różne konfiguracje, ale finalnie wykorzystano sprzęt dostępny pod ręką: urządzenia zalegające w magazynie, w które tchnięto nowe życie. Dokupiono jedynie karty sieciowe i obudowy.
Na etapie projektowania szczególną uwagę zwrócono na cztery rzeczy:
- możliwość rozbudowy bez przebudowy całości,
- prostotę aktualizacji,
- bezpieczeństwo danych,
- wysoką dostępność.
W efekcie z czterech lowendowych komputerów powstał klaster z redundancją danych, który w praktyce nie odbiega od rozwiązań profesjonalnych.
Na czym opiera się GlusterFS
Zintegrowane serwery działają jako węzły połączone siecią TCP/IP i tworzą tzw. zaufaną pulę pamięci. Pula składa się z cegiełek (bricks), z których budowane są woluminy. Woluminy montuje się i używa jak zwykłych nośników danych. Komputer z dostępem jest identyfikowany jako klient, ale nic nie stoi na przeszkodzie, żeby jedna maszyna była jednocześnie klientem i serwerem.
Dokumentacja zaleca minimum trzy serwery, rozumiane szeroko, bo w klastrze może uczestniczyć zarówno sprzęt fizyczny, jak i maszyny wirtualne. Węzły i cegiełki można dodawać w dowolnej liczbie; maksymalny rozmiar zarządzanej przestrzeni liczy się w petabajtach.
Skąd bierze się niezawodność
Gwarancją niezawodności jest redundancja: ryzyko awarii rozkłada się na kilka systemów oddzielonych od siebie przestrzennie, więc awaria jednego nie odcina dostępu do danych.
Warto też znać dwa mechanizmy, które rzadko trafiają do skróconych opisów:
- translatory: dziesięć predefiniowanych warstw tłumaczących polecenia użytkownika; mogą kontrolować dostęp do danych w lokalnym systemie plików albo je szyfrować,
- replikacja geograficzna: asynchroniczna dystrybucja danych między serwerami w różnych lokalizacjach, w układzie master-slave, z transferem zabezpieczonym przez SSH. To ochrona przed czynnikami, na które konfiguracja nie ma wpływu: kradzieżą, zniszczeniem, pożarem.
Typy woluminów
Wybór typu woluminu to wybór między wydajnością, pojemnością i odpornością na awarie.
Distributed maksymalizuje dostępną pojemność. Dwie cegiełki po 100 GB dają dysk 200 GB, a plik trafia tylko do jednej z nich. Algorytm równomiernie wykorzystuje węzły. Ten typ nie jest odporny na awarie: uszkodzenie cegiełki blokuje dostęp do całości, a nawet oznacza utratę danych.
Replicated zapisuje pliki jednocześnie na wszystkich cegiełkach woluminu. Daje lepszą ochronę i dostępność danych przy awarii części systemu, ale pojemność jest ograniczona do pojedynczej cegiełki.
Distributed replicated łączy oba powyższe. Parzyście połączone cegiełki tworzą woluminy w trybie replicated, a powstałe pary są łączone w wolumin distributed. Zwiększa pojemność i zachowuje dostępność danych po awarii cegiełek z różnych par. Nic nie wymusza par: im więcej cegiełek w grupie, tym większa odporność.
Dispersed utrzymuje dostępność danych mimo awarii kilku cegiełek. Na każdej umieszczany jest zakodowany fragment pliku, a do odtworzenia całości wystarcza kod i dostępne fragmenty.
Distributed dispersed to fuzja dwóch powyższych typów. Zwiększa pojemność wersji dispersed przy zestawie cegiełek o identycznej konfiguracji.
Typy striped i distributed striped są przestarzałe i wspierane w ograniczonym zakresie. Dzielą plik na fragmenty zapisywane równocześnie na cegiełkach, co ma sens przy bardzo dużych plikach.
Wady i zalety w porównaniu z klasyczną pamięcią sieciową
Po stronie zalet: dobre wykorzystanie dostępnej pojemności dysków, rozkładanie obciążenia sieci, wyższa niezawodność, bardzo dobra skalowalność, brak opłat licencyjnych i czytelna dokumentacja.
Po stronie wad znajduje się lista, którą warto przeczytać przed podjęciem decyzji:
- konfiguracja jest czasochłonna i wymaga przygotowania sprzętowego oraz kompetencyjnego,
- pełne wykorzystanie funkcji wymaga rozbudowanej sieci: przełączników z agregacją interfejsów, zasilania awaryjnego,
- poziom redundancji trzeba określić już na etapie planowania, nie po fakcie,
- klaster wymaga aktualizacji i nadzoru osób z odpowiednimi kompetencjami; nie jest to macierz sprzętowa, którą się „wstawia i zapomina”.
Gdzie to ma sens
Ponieważ urządzenia łączy protokół internetowy, GlusterFS sprawdza się przy łączeniu struktur firmowych obejmujących kilka oddziałów. Działa jednak równie dobrze w jednej lokalizacji, więc również mniejsze organizacje mogą w ten sposób powiększyć przestrzeń na dane.
Alternatywy
Ceph jest dostępny za darmo i w dużym stopniu powiela zalety oraz wady GlusterFS. BeeGFS jest bezpłatny, opracowany przez Towarzystwo Fraunhofera i przeznaczony do systemów obliczeniowych dużej mocy. S2D (Storage Spaces Direct) to komercyjne rozwiązanie Microsoftu oparte na płatnych licencjach Windows Server.